 粤公网安备44200102446416号 ·
意见反馈 ·
zsweiluo@163.com
真题解析 · 免费诊断 · 知识点精讲 · GESP 刷题 · CSP-J 刷题 · CSP-S 刷题 · NOIP 刷题 · AI 伴学 · 帮助中心
真题来源:中国计算机学会(CCF)CCF-GESP / CSP / NOIP 认证试题;本页解析由 OI伴学提供。
下面的冒泡排序中尝试提前结束比较过程,横线处应该填写的代码是( )。 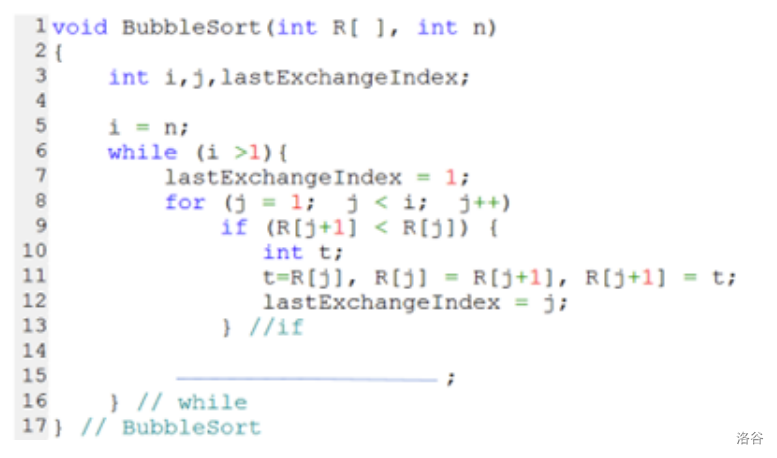
拿到题先看变量名,lastExchangeIndex 就是这轮冒泡最后发生交换的位置,说明它右边的元素已经排好序了。内层循环的上限应该从 n-1-j 收缩到 lastExchangeIndex,这样才能跳过已有序部分。
学生最容易死记硬背冒泡排序的标准写法,看到优化就硬套 i = lastExchangeIndex + 1,完全没想为什么是 +1 而不是 +0 或 -1。其实命题人挖的坑就在于边界定义:lastExchangeIndex 记录的是发生交换的最后一个下标,这个下标本身还没被确认“绝对稳定”(因为它刚动过),所以下一轮必须从它后面一位开始,也就是 +1。选错的人往往是因为没理解“已排序区间”是从哪里开始的,或者被选项 D 里莫名其妙的 j 干扰了思路。
【考点】排序算法|冒泡排序优化|边界条件
命题人考察冒泡排序的进阶优化,卡住大量学生只背基础流程、不懂“已排序区间”缩小的核心逻辑。冒泡排序每轮内层循环负责把最大元素“沉底”,同时记录最后发生交换的位置 lastExchangeIndex。任何在 i > lastExchangeIndex 处的交换都发生在下一轮,因为当前轮中该区间已稳定,下一轮只需遍历到 lastExchangeIndex 即可。故横线应填 i = lastExchangeIndex + 1,把内层上限从 n - 1 - j 收缩为 lastExchangeIndex。这是“缩小比较区间”的通用套路,同样适用于选择排序、插入排序的优化。
四个选项的坑:B 把最后交换点往回推,忽略了该点左侧仍可能无序;C 重复比较已稳定位置;D 则是把趟数混入索引,纯属命题人设的“算术陷阱”。只背结论的学生最容易选错。
反命题:若把条件改为 i = lastExchangeIndex - 1,会重新比较已稳定的元素,优化意义尽失;若改为 i = lastExchangeIndex,则下一轮仍从错误位置开始,可能破坏排序。命题人用 +1 而非 +0 或 -1,就是考你“稳定区间”的边界定义。刷到类似题,先问自己“这个变量到底在标记什么”,再决定边界如何收。
【考频与趋势】排序基础在题库共考过 249 题,覆盖 9 个考试级别(2008-2026),近年考频飙升:2023 年 22 题、2024 年 51 题、2025 年 57 题、2026 年 50 题,说明该知识点已成为高频考点。sort 排序考过 128 题,其中 GESP 八级占 26 题,与本题级别吻合。算法类题目共 7 题,分布较散,但排序相关题目在 GESP 八级中占比稳定。
【预测】基于数据,排序基础在 GESP 八级中已连续多年保持较高考频(2023-2026 年均值约 45 题),且题目形式正从单纯代码填空转向更侧重边界条件和优化逻辑的考察。预计未来 GESP 八级排序题仍会高频出现,且更可能考查冒泡、选择、插入排序的优化细节(如 lastExchangeIndex 的使用、提前结束条件等)。暂无足够依据预测具体年份或题型变化,但建议重点复习排序优化中的边界收缩逻辑。
粤公网安备44200102446416号 ·
意见反馈 ·
zsweiluo@163.com