本讲学习目标
- 能说清哈希冲突、开放定址 / 链地址、装填因子三个初赛高频概念
- 会在数组桶 / set / map 三个容器之间按值域和用途正确选型
- 掌握三类实战套路:计数去重、字符串↔编号映射、把 O(n²) 判定降成 O(n)
- 记住「判断存在用 count 不用 []」「配对检查必须先查后插」两个高频坑
概念
哈希表(Hash Table),你可以把它想象成一个超级高效的“自动索引柜”。 想象你在图书馆找一本书,如果书架上全是书,你得从第一本一本翻过去,这叫线性查找,书越多越慢。 而哈希表的做法是:给每本书贴一个“座位号”。你想找《算法导论》,不用翻书架,直接去“座位号 105”那个格子,要么书在那儿,要么没书。 在编程里,这个“座位号”就是下标,这个“格子”就是数组。 但是,我们存的东西(比如一个很长的名字、一个巨大的数字)通常没法直接当下标用。怎么办? 我们需要一个哈希函数(Hash Function),它的作用就是把任意复杂的“东西”,通过一套固定的数学规则,算出一个整数下标。 所以,哈希表 = 哈希函数 + 一张存储数据的表。 它的核心能力就是:存(把东西放进去)和 查(给个东西,秒回它在哪)。平均情况下,存和查都是 O(1),也就是常数时间,跟数据量无关,快得惊人。
触发清单(看到这些信号第一时间想到本知识点)
| 题干信号 | 优先考虑什么 | 对应思路 |
|---|---|---|
| 题目反复问「这个东西出现过没有 / 出现过几次」 | 计数容器 | 用数组桶或 map/set 统计频率 |
| 要把字符串当作 key 去查(人名、单词、颜色) | 映射容器 | 用 map<string,int> 把字符串转编号 |
| 暴力是「两层循环两两比较」(O(n²)),想降到 O(n) | 加速判定 | 用哈希表把内层循环换成一次查表 |
| 要去重统计“不同种类数” | 集合容器 | 用 set 自动去重,看 size |
| 值域很大(到 1e9)不能直接开数组当桶 | 离散化/映射 | 用 map 或先离散化再开桶 |
定义
哈希表的核心在于哈希函数的构造与冲突的处理。下面逐一拆解。
1. 哈希冲突与解决流派
哈希冲突(Hash Collision):不同的 key 算出了同一个下标。 这是必然发生的(因为 key 空间通常远大于表空间,就像把 100 个人塞进 10 个格子,肯定有人撞车)。工程上要“解决冲突”。 解决冲突的两大流派: 1. 开放定址法(Open Addressing):冲突了就往后找下一个空位(线性探测、二次探测……); 2. 链地址法(Chaining,也叫拉链法):每个下标挂一个链表,冲突的都挂在同一条链上。
2. 装填因子
装填因子(Load Factor,记为 $\alpha$)= 已存元素数 / 表长度。 $\alpha$ 越大冲突越多。$\alpha$ 超过 0.7 左右就考虑扩容(重新哈希)。
3. 复杂度
| 操作 | 平均 | 最坏 |
|---|---|---|
| 插入 / 查找 / 删除 | O(1) | O(n)(全部冲突挤在一处) |
4. 哈希函数构造的常用方法
哈希函数构造(Hash Function Construction):把 key 映射到整数下标的规则。 初赛考过这些方法:
| 方法 | 做法 |
|---|---|
| 直接定址 | H(k) = k(值域小时最好) |
| 除留余数法 | H(k) = k mod p,p 取质数冲突最少 |
| 数字分析法 | 取 key 中分布较均匀的几位 |
| 平方取中法 | 先平方,取中间几位 |
| 折叠法 | 把 key 分段相加 |
提高级大纲(2.3.5.1 数值哈希函数构造)把构造法拆得更细,共 4 种,初赛会直接考「给了H和插入序列,手算冲突/分布」: - ① 除余法H(x) = x mod p,p通常取质数(质数作模数让余数更均匀,冲突更少); - ② 平方取中法 先算x²,再取平方值中间若干位(或二进制表示的中间若干比特)作哈希值——适合 key 分布较密时让结果更分散; - ③ 折叠法 若 key 位数较多,把它划分成几段,把各段相加(或加减交替)作为哈希值; - ④ 乘余取整法 针对浮点数:先乘常数α (0<α<1),取乘积的小数部分,再乘整数n后下取整,即H(x) = ⌊ n·(α·x mod 1) ⌋。
字符串哈希(2.3.5.2):把字符映射成 0..M-1 的整数,字符串就被看成 M 进制数,再对 p 取余。它有一套高效的「滚动」写法(见下方「字符串滚动哈希」)。四种数值构造法 + 字符串哈希的整体图示见:

5. 字符串滚动哈希
字符串滚动哈希(Rolling Hash):把字符串S看成M进制数,从左到右递推求前缀哈希。 这是 Rabin–Karp 算法的核心,能 O(1) 取任意子串哈希。
// H(S[1..i]) = (H(S[1..i-1]) * M + v_i) mod p,v_i 是第 i 个字符的编号(如 'a'→1)
const int M = 131, p = 1000000007; // M、p 都取大质数,降低碰撞概率
vector<long long> h(n + 1), pw(n + 1);
h[0] = 0; pw[0] = 1;
for (int i = 1; i <= n; i++) {
 h[i] = (h[i-1] * M + (S[i])) % p; // 前缀递推:每进一个字符就整体乘 M 进一位
 pw[i] = pw[i-1] * M % p; // 预存 M^i mod p,子串公式要用
}
取任意子串 S[i..j] 的哈希(O(1))——关键公式:H(S[i..j]) = (H(S[1..j]) − H(S[1..i-1])·M^(j−i+1)) mod p:
long long subHash(int i, int j) {
 // H[1..j] 比 H[1..i-1] 多乘了 (j-i+1) 次 M,减时把后者补乘 M^(j-i+1) 对齐再减
 return (h[j] - h[i-1] * pw[j-i+1] % p + p) % p; // +p 防止出现负数
}直觉:H[1..j]和H[1..i-1]是同一进制下的「数」,差一位就差一个M的幂次;补乘M^(j−i+1)后相减,正好消掉i之前的前缀,只留下S[i..j]的哈希。配合双哈希(两套M,p)可进一步防碰撞,常用于字符串匹配 / 判回文 / 最长重复子串。
6. 冲突处理:链地址法 vs 开放定址法
冲突处理(Collision Resolution):大纲给的常用解法有三类: - 多哈希函数法:第一函数冲突就换第二函数(不同函数模数取互素,降低相关性); - 开散列 / 链地址法(拉链法):每个槽挂一条链表,冲突元素依次接在后面(见下图左); - 闭散列 / 开放定址法:冲突时不挂链,而是到表里找下一个空位,常用线性探查(依次往后)和二次探查(按 2 的幂偏移在两侧找)。
链地址法插入/删除简单,但有指针开销、缓存不友好;开放定址法无指针,但易「聚集」,删除要用「标记删除」而不能真删。装填因子α越大约冲突越多,一般α>0.7就考虑扩容重新哈希。
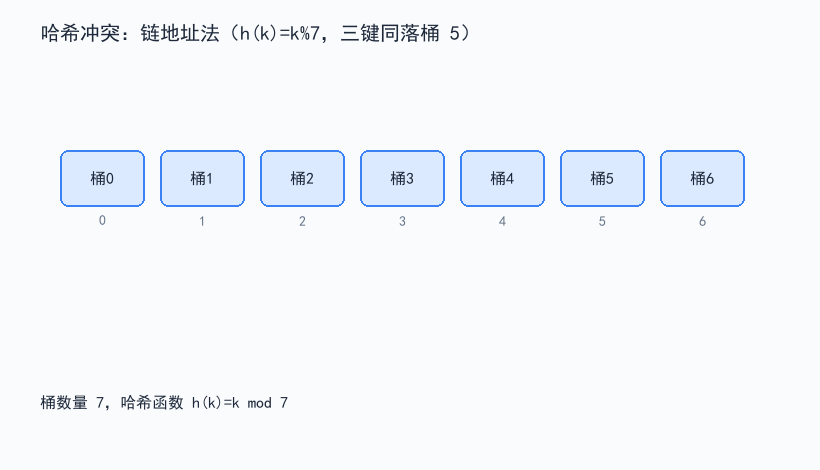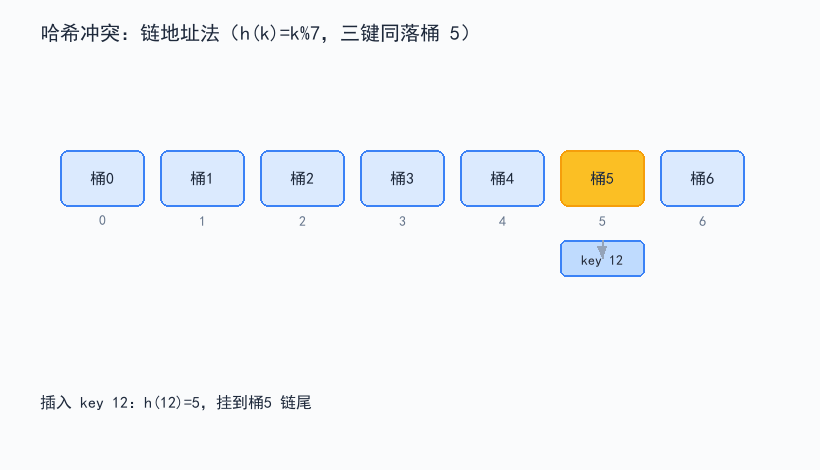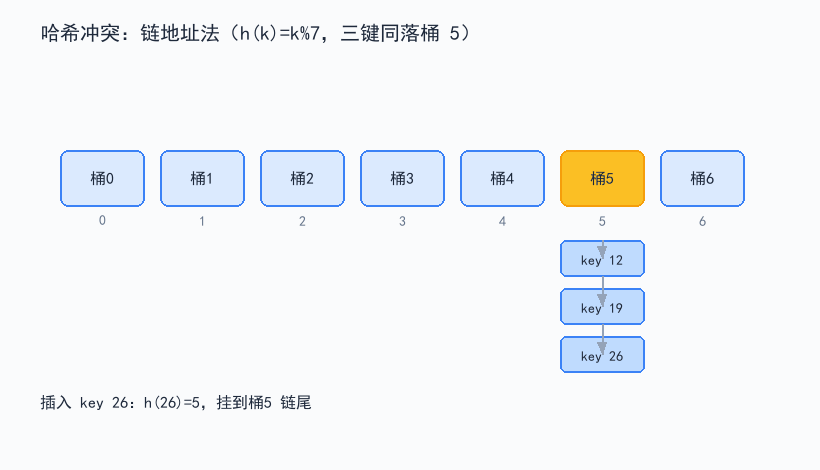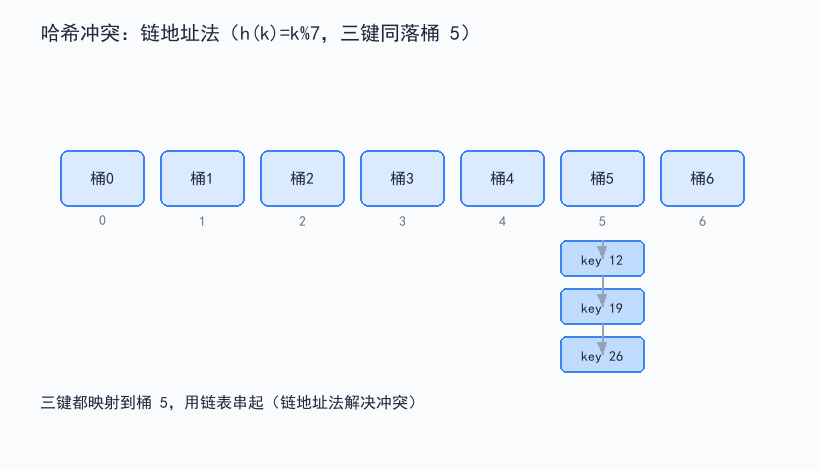
技巧速查表(背下来)
| 想做的事 | 写法 | 说明 |
|---|---|---|
| 值域小计数 | cnt[x]++ | 数组桶,最快 |
| 大数/字符串计数 | map<string,int> cnt | 自动哈希映射 |
| 去重 | set<int> s; s.insert(x) | 自动去重 |
| 存在性判断 | s.count(x) | 不插入,只查 |
| 字符串转编号 | map<string,int> id | 首次出现分配新 id |
| 滚动哈希前缀 | h[i] = (h[i-1]*M + v)%p | 线性递推 |
| 滚动哈希子串 | (h[j] - h[i-1]*pw[len]%p + p)%p | 对齐相减 |
例题
例题 1:两数之和(经典 O(n²) → O(n) 转化)
题目描述:
给定一个整数数组 a 和一个目标值 target,判断数组中是否存在两个不同的元素,它们的和等于 target。如果存在,返回 true;否则返回 false。
数组长度 n 满足 1 ≤ n ≤ 5000,元素绝对值不超过 10^9。
审题分析:
- 读题抓条件:需要找“两个数之和等于 target"。
- 定需求:暴力做法是枚举所有数对
(i, j),检查a[i] + a[j] == target。 - 为什么能用本知识点:暴力是两层循环,复杂度
O(n²)。当n较大时(比如10^5),O(n²)会超时。如果我们能把“找配对的另一个”变成“查表里有没有”,就能把内层循环消掉,变成O(n)。 - 如果不用会怎样:如果坚持用两层循环,当
n=10^5时,操作次数约为10^{10},远超 1 秒能处理的10^8量级,必然超时。
解题思路:
1. 遍历数组,对于当前元素 x,我们想知道“是否存在一个之前的元素 y,使得 x + y == target"。
2. 这等价于问:“target - x 这个数,之前出现过吗?”
3. 用一个哈希集合(unordered_set)记录已经遍历过的数字。
4. 每遇到一个新数字 x,先查集合里有没有 target - x,如果有,直接返回 true。
5. 查不到,就把 x 加入集合,供后面的数字使用。
6. 遍历结束都没找到,返回 false。
C++ 完整参考代码:
#include <iostream>
#include <vector>
#include <unordered_set>

using namespace std;

// 主函数:判断是否存在两数之和等于 target
bool twoSum(const vector<int>& a, int target) {
 // 用一个哈希集合记录已经遍历过的数字
 unordered_set<int> seen;

 // 遍历数组中的每一个元素
 for (int x : a) {
 // 关键步骤:先查后插
 // 计算我们需要找的“搭档”是多少
 int complement = target - x;

 // 如果搭档已经在集合里出现过,说明找到了答案
 if (seen.count(complement)) {
 return true;
 }

 // 如果没找到,就把当前数字 x 加入集合
 seen.insert(x);
 }

 // 遍历完都没找到
 return false;
}

int main() {
 // 输入数组大小
 int n;
 cin >> n;

 // 输入数组元素
 vector<int> a(n);
 for (int i = 0; i < n; i++) {
 cin >> a[i];
 }

 // 输入目标值
 int target;
 cin >> target;

 // 调用函数并输出结果
 if (twoSum(a, target)) {
 cout << "true" << endl;
 } else {
 cout << "false" << endl;
 }

 return 0;
}代码解读:
unordered_set<int> seen;:定义一个哈希集合,自动处理哈希冲突,平均O(1)插入和查找。- 循环
for (int x : a):遍历数组。 int complement = target - x;:计算需要的搭档。if (seen.count(complement)):利用哈希表的查找能力,直接判断搭档是否存在,时间复杂度O(1)。seen.insert(x);:将当前数字加入集合,供后续使用。- 注意:先查后插。如果先插再查,当数组中有两个相同的数且它们的和等于
target时,会错误地认为找到了(自己和自己配对)。先查保证了配对的两个数一定是不同的。
运行结果:
假设输入:
5
3 5 1 2 4
6
输出:
true解释:3 + 3 = 6(但题目要求两个不同的元素,这里 3 只出现一次,所以实际上是 1 + 5 = 6 或 2 + 4 = 6,都能找到)。
再假设输入:
4
1 2 3 4
10
输出:
false解释:最大和是 3 + 4 = 7 < 10,找不到。
例题 2:字符串去重计数
题目描述:
给定一个字符串数组 words,统计其中有多少个不同的字符串。
数组长度 m 满足 1 ≤ m ≤ 10^5,每个字符串长度不超过 100。
审题分析:
- 读题抓条件:要统计“不同字符串”的个数。
- 定需求:如果直接两两比较字符串是否相等,复杂度是
O(m² * L)(L 是字符串平均长度),当m=10^5时会超时。 - 为什么能用本知识点:我们需要一个容器,能自动去重,并且能高效判断某个字符串是否已经出现过。哈希集合
unordered_set<string>正好满足:把字符串作为 key,自动哈希,插入和查找都是平均O(1)。 - 如果不用会怎样:如果用
map<string,int>计数,虽然也能去重,但map是红黑树实现,查找是O(log m),总复杂度O(m log m * L),比unordered_set慢一些;如果用排序去重,需要额外O(m log m * L)的排序开销,且会打乱原顺序(虽然题目只要求计数,但排序去重代码更繁琐)。
解题思路:
1. 定义一个 unordered_set<string> 用来存去重后的字符串。
2. 遍历输入的每个字符串,直接插入集合。
3. 集合会自动处理重复:如果字符串已经存在,插入操作不会增加集合大小。
4. 遍历结束后,集合的 size() 就是不同字符串的个数。
C++ 完整参考代码:
#include <iostream>
#include <vector>
#include <string>
#include <unordered_set>

using namespace std;

int main() {
 // 输入数组大小
 int m;
 cin >> m;

 // 用哈希集合自动去重
 unordered_set<string> distinct_words;

 // 遍历输入
 for (int i = 0; i < m; i++) {
 string word;
 cin >> word;
 distinct_words.insert(word);
 }

 // 输出不同字符串的个数
 cout << distinct_words.size() << endl;

 return 0;
}代码解读:
unordered_set<string> distinct_words;:定义一个哈希集合,key 是字符串。distinct_words.insert(word);:插入字符串。如果word已经存在,集合大小不变;如果不存在,集合大小加 1。distinct_words.size():返回集合中元素的个数,即不同字符串的个数。
运行结果:
假设输入:
5
apple
banana
apple
cherry
banana
输出:
3解释:apple、banana、cherry 三个不同的字符串。
例题复盘总结
共性特征
- 两道题都涉及“是否存在/统计”的查询需求,且数据量较大,暴力两两比较会超时。
- 都利用了哈希表平均 O(1) 的查找特性,把内层循环或两两比较消掉。
- 都需要注意“先查后插”或自动去重的细节。
各自技巧
- 两数之和:核心技巧是把“找配对的另一个”转化为“查表里有没有”,用
complement = target - x这一招。 - 字符串去重:核心技巧是直接用
unordered_set的自动去重能力,无需手动判断重复。
审题模板(固定思考流程)
1. 看值域/数据类型:值域小开数组桶,值域大或字符串用 map/unordered_map,只要去重用 set/unordered_set。
2. 看是否要“两两比较”:如果是,立刻想“能不能用哈希把内层循环换成一次查表”。
3. 看是否要“统计次数”:如果是,想“数组桶还是 map 计数”。
4. 注意细节:先查后插、用 count() 判断存在、unordered_* 可能被卡数据用 map。
错误清单(特有错误)
- 该开数组桶却开了
map:值域只有1e6时,cnt[x]++比map[x]++快好几倍。先看值域。 - 用
map[k] == 0判断“不存在”:map的[]会插入一个默认值,污染计数。判断存在要用count()或find()。 - “先插入后查询”导致自己和自己配对:检查配对时必须先查、再插(见上面两数之和的写法)。
unordered_map在出题人构造的数据下退化:某些平台的unordered_map会被卡成O(n)(哈希碰撞攻击)。正式比赛里常用map(稳定O(log n))更保险,或者给unordered_map换随机哈希。map的O(log n)被忽略:数据1e6时,map的常数比unordered_map大不少,但通常都够用;1e7就要留意了。
写法总表
| 技法分层 | 解决什么 | 典型写法 |
|---|---|---|
| 数组桶 | 值域小的计数/去重 | cnt[x]++ / set |
| map/unordered_map | 大数/字符串计数/映射 | map<string,int> cnt |
| set/unordered_set | 去重/存在性判定 | s.count(x) |
| 滚动哈希 | 字符串子串匹配/判回文 | h[i] = (h[i-1]*M + v)%p |
| 哈希加速判定 | 把 O(n²) 降 O(n) | 边扫边查表 |
分工说明:触发清单告诉你“什么时候想到用哈希”,速查表告诉你“具体怎么写”,总表告诉你“不同场景选哪种写法”。
常见错误
1. 该开数组桶却开了 map。 值域只有 1e6 时,cnt[x]++ 比 map[x]++ 快好几倍。先看值域。
2. 用 map[k] == 0 判断“不存在”。 map 的 [] 会插入一个默认值,污染计数。判断存在要用 count() 或 find()。
3. “先插入后查询”导致自己和自己配对。 检查配对时必须先查、再插(见上面两数之和的写法)。
4. unordered_map 在出题人构造的数据下退化。 某些平台的 unordered_map 会被卡成 O(n)(哈希碰撞攻击)。正式比赛里常用 map(稳定 O(log n))更保险,或者给 unordered_map 换随机哈希。
5. map 的 O(log n) 被忽略。 数据 1e6 时,map 的常数比 unordered_map 大不少,但通常都够用;1e7 就要留意了。
自测
1. 哈希表「平均 O(1)、最坏 O(n)」分别是什么情况造成的?
2. 解决哈希冲突的两大流派是什么?各说一句特点。
3. 装填因子的定义是什么?为什么要扩容?
4. 数组桶、set、map 分别在什么场景下用?
5. 为什么“判断 key 是否存在”不能用 map[k] == 0?
6. 用哈希把“两数之和”降到 O(n) 的核心转化是什么?为什么必须先查后插?
举一反三 · 审题流水线
拿到题先别急着写代码,按这个流水线走一遍:
1. 看值域:≤1e7 就开数组桶,>1e7 或字符串就 map。
2. 看需求:计数就用桶/map,去重就用 set,存在性就用 set 的 count。
3. 看循环:有没有两层循环两两比较?有就立刻想“能不能用哈希把内层换成一次查表”。
4. 看细节:配对题先查后插,存在性判断用 count 不用 [],unordered_* 在正式比赛优先换 map。
练手题
题目 A:给定一个整数数组 a,统计其中有多少个不同的数。
输入格式:第一行一个整数 n(1 ≤ n ≤ 10^5),第二行 n 个整数 a[1..n](绝对值 ≤ 10^9)。
输出格式:一个整数,表示不同数的个数。
题目 B:给定一个字符串 s 和一个目标字符串 t,判断 s 中是否存在 t 作为子串。
输入格式:第一行两个整数 n, m(1 ≤ n, m ≤ 10^5),第二行字符串 s(长度 n),第三行字符串 t(长度 m)。
输出格式:如果存在输出 yes,否则输出 no。
提示:可以用滚动哈希 + 二分查找,或者直接用 KMP 算法。
学完这个考点,用历年真题检验一下
OI伴学 把「哈希表」在 CCF-GESP / CSP / NOIP 真题里出现过的题目汇总到一页,可按考点横向刷;每题都带答案、解题思维和常见错误。
看 哈希表 历年真题汇总 → 去平台刷题 → 粤公网安备44200102446416号